De uitdaging
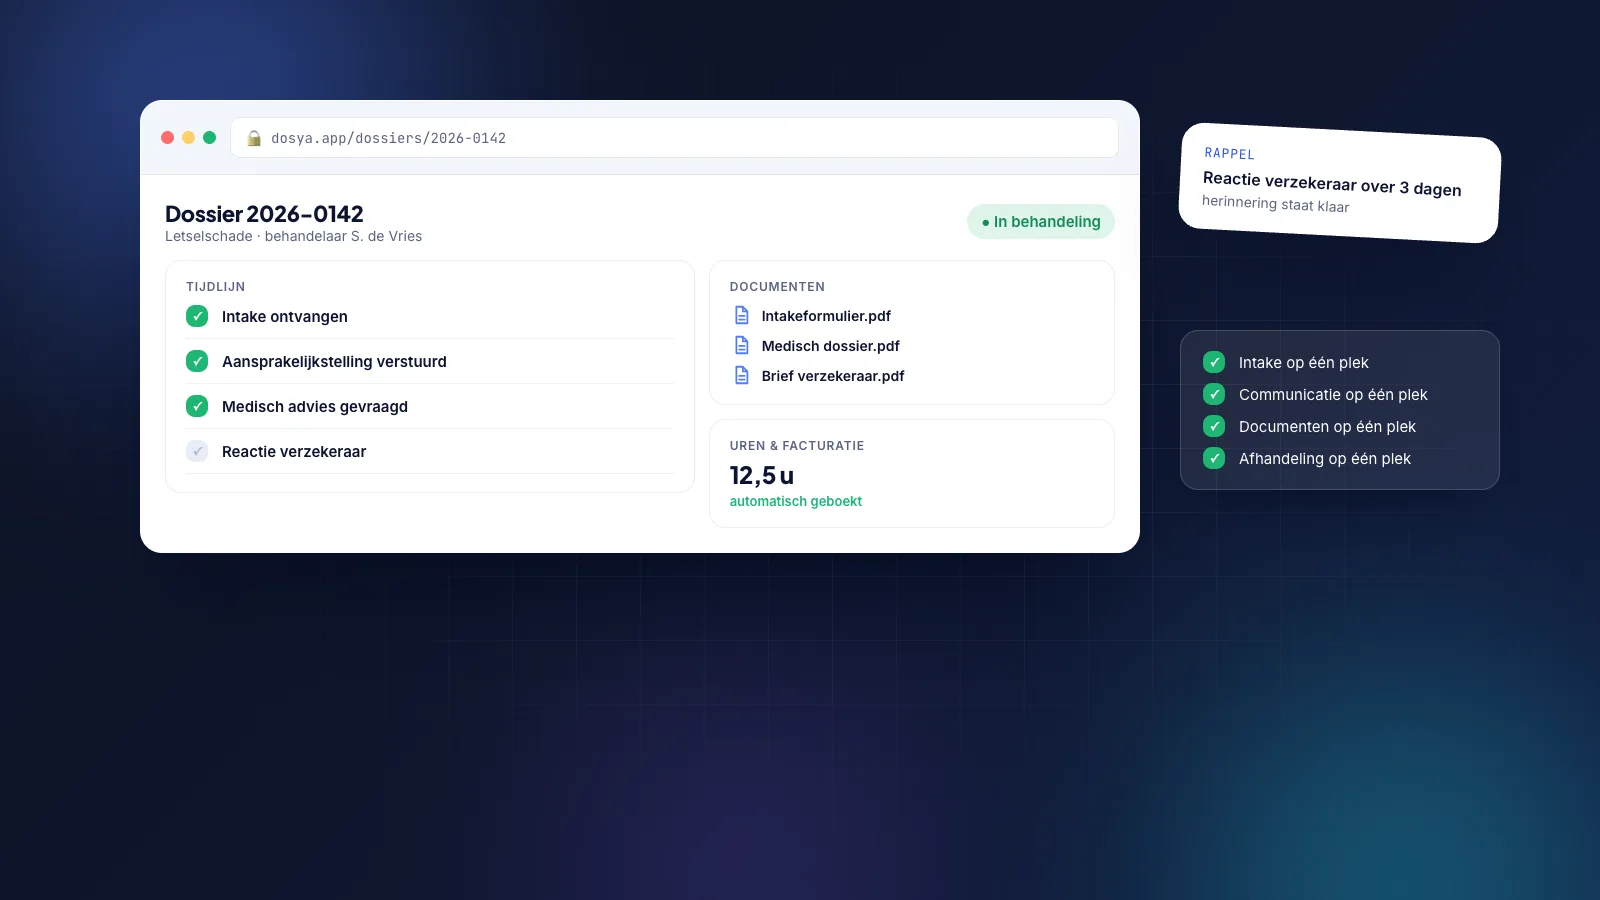
In een dossierproces komt het meeste werk binnen als document: brieven van verzekeraars, medische informatie, facturen, rapportages en bijlagen bij e-mails. Iemand moet elk stuk openen, bepalen bij welk dossier het hoort, lezen wat erin staat, het registreren en vaak een reactie schrijven.
Dat werk is niet moeilijk, maar wel veel, en het onderbreekt het echte werk van de behandelaar. Bovendien blijft een stuk dat verkeerd wordt weggezet soms weken onopgemerkt.
De aanpak
We hebben het proces opgeknipt in stappen die software goed kan (lezen, herkennen, sorteren, samenvatten, voorbereiden) en stappen die bij de behandelaar horen (beoordelen, beslissen, versturen). De AI mag alles voorbereiden, maar niets zelfstandig naar buiten sturen of definitief maken.
We begonnen met één documenttype en één dossierstap, keken een paar weken mee hoe vaak de herkenning klopte en breidden daarna uit. Bij elke stap logt het systeem wat het heeft gedaan en waarom, zodat een behandelaar het altijd kan controleren.
Wat we bouwden
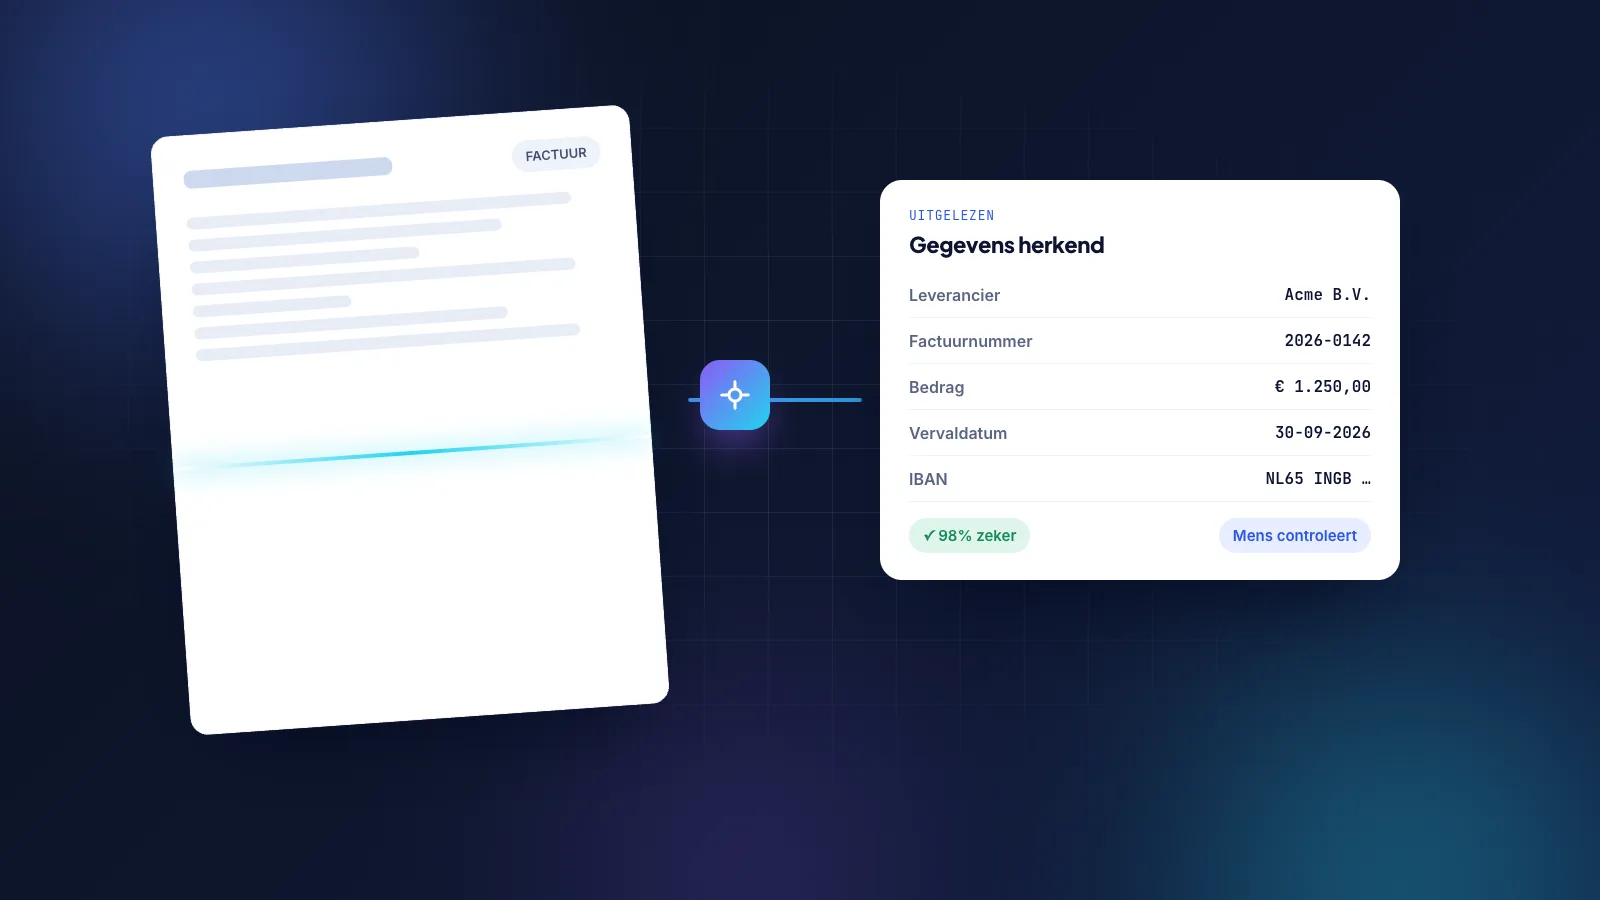
- Uitlezen. Post, scans en e-mailbijlagen worden met OCR omgezet naar tekst, ook als het gescande of gefotografeerde documenten zijn.
- Classificeren en koppelen. Een taalmodel herkent het documenttype en de kenmerken (dossiernummer, partij, datum) en hangt het stuk aan het juiste dossier. Bij twijfel gaat het naar een controlelijst.
- Samenvatten. Lange stukken krijgen een korte samenvatting met de relevante punten voor de behandelaar, met verwijzing naar de passages in het origineel.
- Conceptbrieven. Standaardcorrespondentie, zoals een aansprakelijkstelling, wordt als concept klaargezet op basis van het dossier en de sjablonen van het kantoor. De behandelaar past aan en verstuurt.
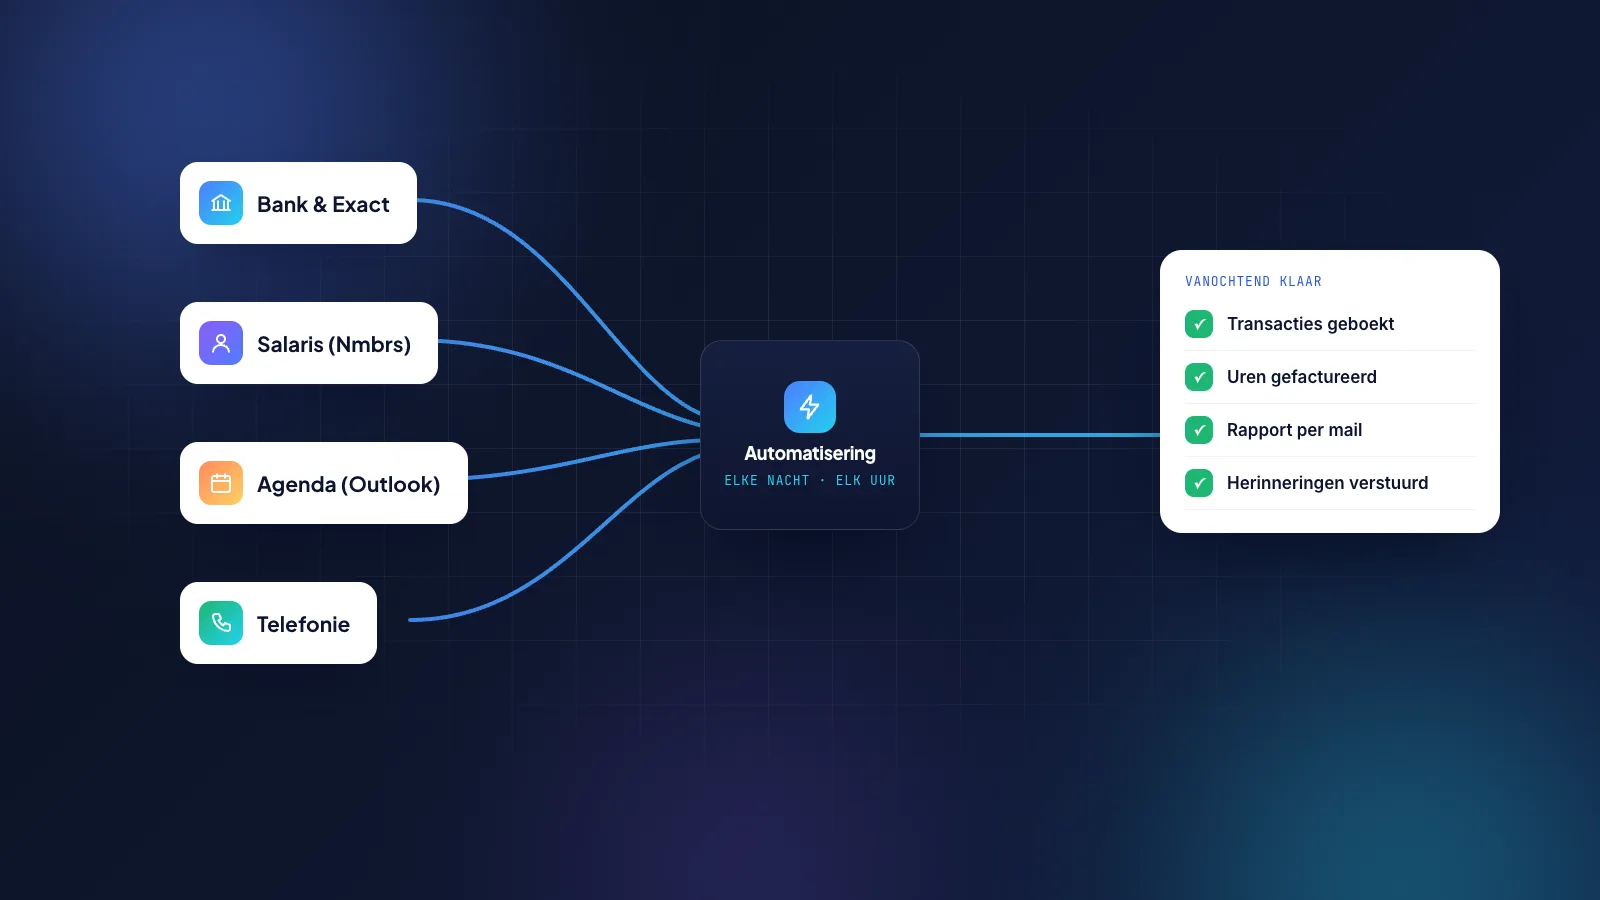
- Nachtelijke controles. Facturen en adviezen worden 's nachts door AI nagekeken op afwijkingen ten opzichte van het dossier; afwijkingen leveren de volgende ochtend een melding op.
- Kennis en vragen. Dezelfde techniek beantwoordt vragen van medewerkers op basis van de eigen werkwijzen en handleidingen, met bronvermelding (zie Dosya Kennis).
Privacy en techniek
Medische en juridische stukken vragen om zorgvuldigheid. Documenten worden verwerkt op infrastructuur binnen de EU, worden niet gebruikt om modellen te trainen en zijn alleen zichtbaar voor de rollen die daartoe bevoegd zijn. Elke automatische handeling wordt gelogd.
Technisch combineren we OCR met taalmodellen die we via strikte instructies en controles inzetten. Waar het kan gebruiken we vaste regels; alleen waar taalbegrip nodig is, komt het model eraan te pas. Zo blijft het gedrag voorspelbaar en controleerbaar. Meer over onze uitgangspunten lees je op AI & data.
Wat we ervan leerden
De grootste winst zit niet in het spectaculaire, maar in het saaie: documenten die zonder handwerk op de juiste plek landen en samenvattingen die een behandelaar in een minuut bijpraten. En: het systeem moet eerlijk zijn over twijfel. Een AI die bij onzekerheid een collega inschakelt, wordt gebruikt; een AI die altijd zeker klinkt, wordt gewantrouwd.
Lees ook ons artikel over AI-documentverwerking van facturen en formulieren.