De belangrijkste punten
- AI-documentverwerking combineert tekstherkenning (OCR) met taalmodellen die begrijpen welk veld wat betekent.
- Het werkt goed bij documenten met een vaste betekenis, zoals facturen en formulieren, en minder bij interpretatie.
- Een mens-in-de-lus blijft nodig: onzekere uitkomsten gaan altijd langs een controlescherm.
- Elk herkend veld moet verwijzen naar de plek in het document; geen bron, geen waarde.
- Persoonsgegevens verwerk je in de EU, met een verwerkersovereenkomst en zonder dat je documenten modellen trainen.
In het kort
AI-documentverwerking is software die een binnenkomend document herkent, de tekst eruit haalt en de gegevens die je nodig hebt in gestructureerde velden zet: factuurnummer, bedrag, btw, naam, datum, handtekening aanwezig of niet. Het combineert klassieke tekstherkenning (OCR) met taalmodellen die snappen dat "totaal te voldoen" hetzelfde betekent als "eindbedrag". Het werkt goed voor facturen, aanvraag- en intakeformulieren en het ophalen van kerngegevens uit contracten. Het werkt minder goed bij slechte scans, handschrift en vragen die interpretatie vergen. Daarom richt je het altijd in met validatieregels en een controlestap door een mens.
Hoe het werkt: OCR plus taalmodel
Onder de motorkap zijn er zes stappen. Je hoeft ze niet zelf te bouwen, maar het helpt om ze te kennen, omdat elke stap zijn eigen fouten maakt.
- Ontvangen. Het document komt binnen via een mailbox, een upload in een klantportaal, een scanner of een foto op de telefoon.
- Classificeren. Is dit een factuur, een intakeformulier, een polisblad of een brief? De software bepaalt het type, zodat het juiste vervolg wordt gekozen.
- Tekst herkennen. OCR zet pixels om in tekst, met per woord een positie op de pagina en een zekerheidsscore. Bij een digitaal aangemaakte PDF is deze stap vaak overbodig omdat de tekst er al in zit.
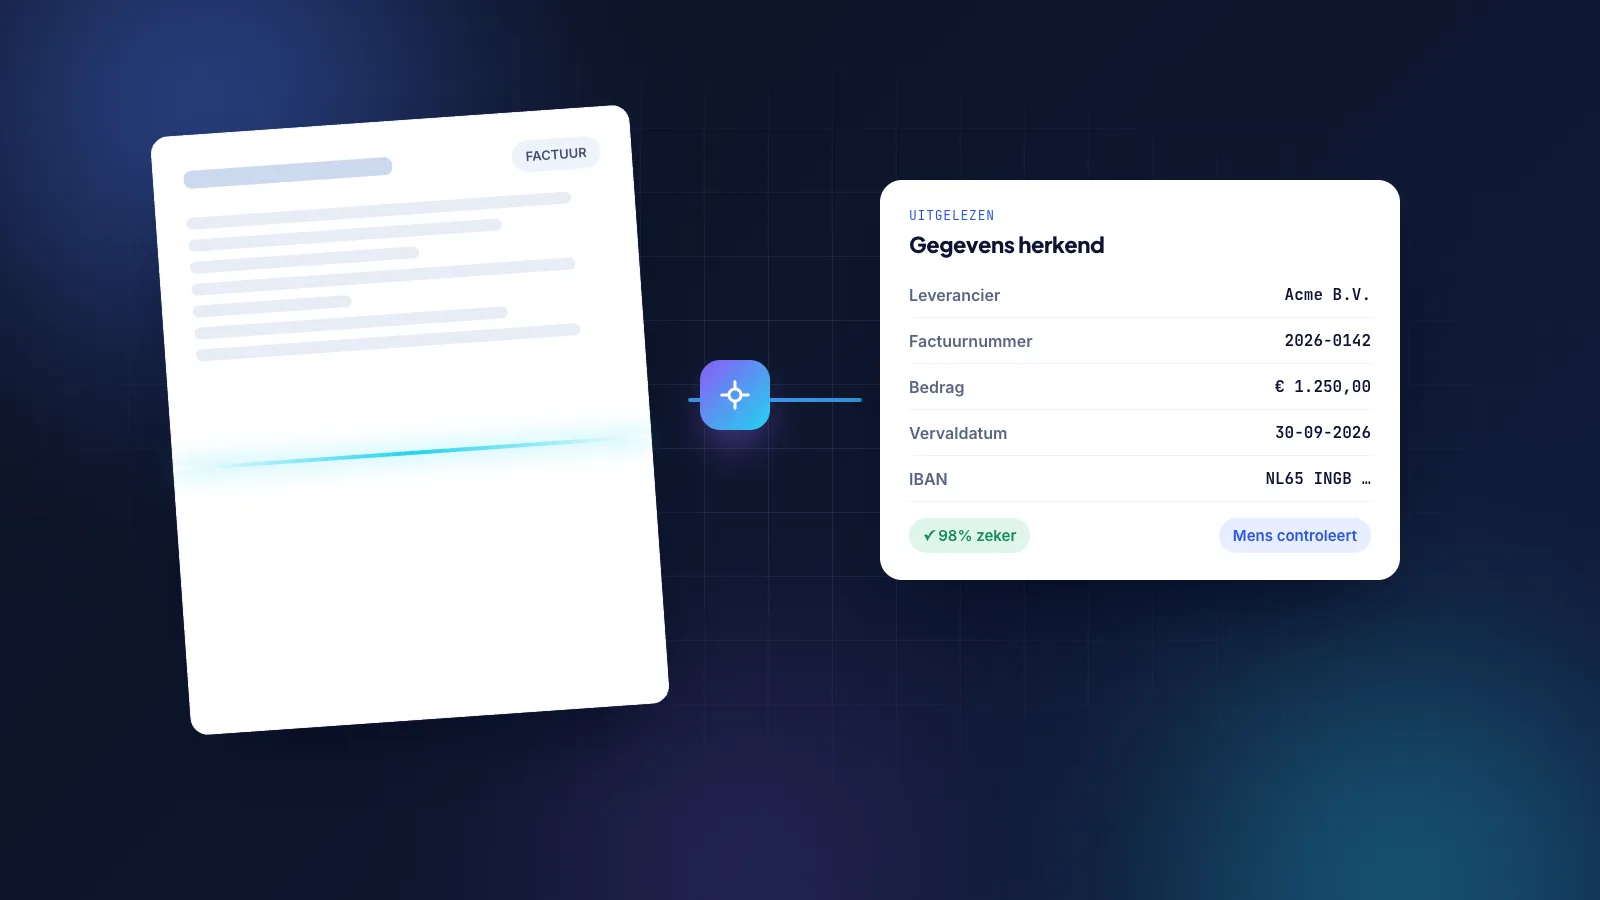
- Velden ophalen. Hier komt het taalmodel om de hoek. Het krijgt de tekst, de lay-out en een lijst met velden die jij wilt hebben, en geeft per veld een waarde terug. Het weet dat het bedrag naast "totaal" hoort en dat de datum bovenaan de factuurdatum is en niet de vervaldatum.
- Valideren. Regels controleren de uitkomst: klopt het btw-bedrag met het percentage, bestaat de leverancier al, is het IBAN geldig, ligt de datum niet in de toekomst.
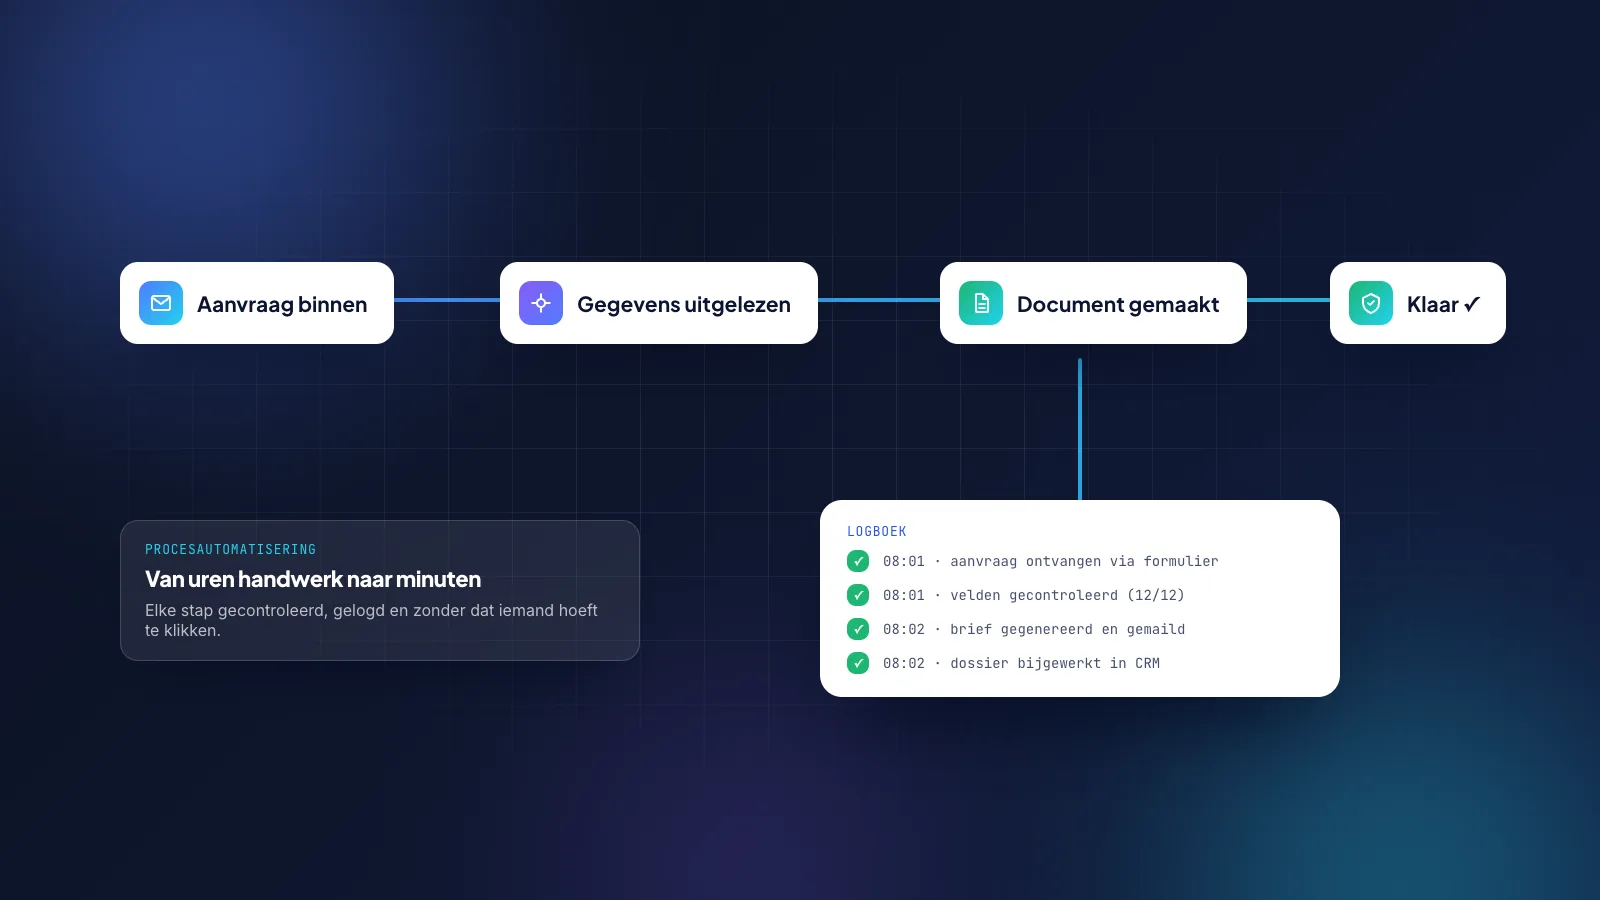
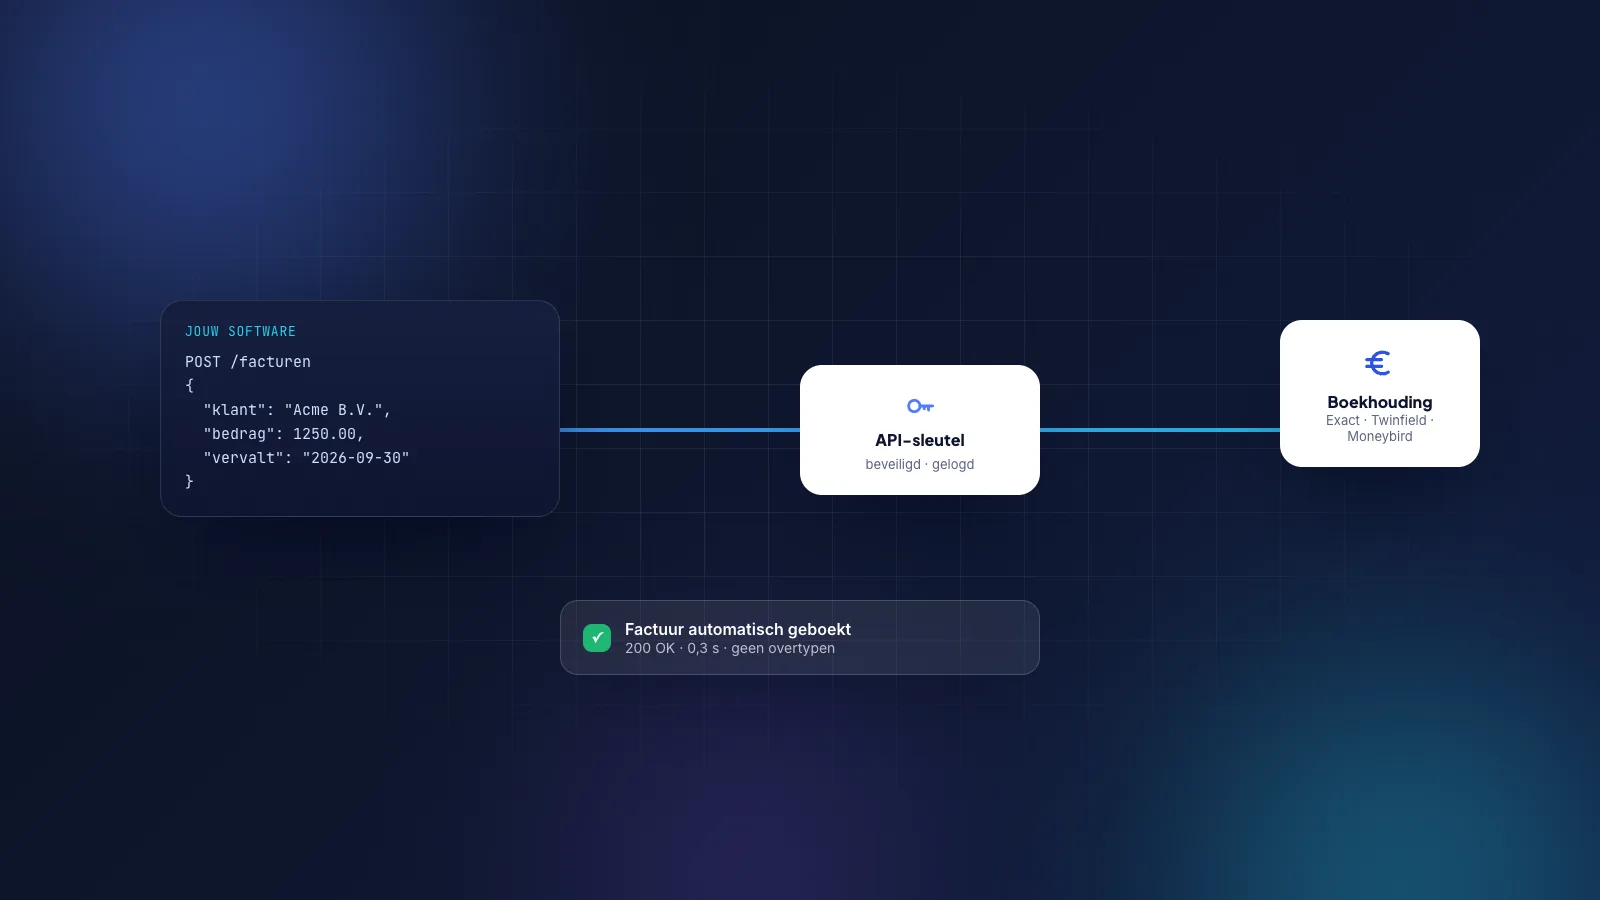
- Wegschrijven. De gegevens gaan naar je eigen software, je boekhouding of je dossiersysteem, samen met het originele document en een logboek van wat is herkend.
Waarom OCR alleen niet genoeg is
Klassieke OCR geeft je een lap tekst. Om daar velden uit te halen moest je vroeger per leverancier een sjabloon maken: het bedrag staat rechtsonder, het nummer linksboven. Elke nieuwe lay-out was werk. Taalmodellen begrijpen de betekenis van de tekst, waardoor één instructie ook werkt voor een leverancier die je nog nooit hebt gezien. Dat is de echte verandering van de afgelopen jaren.
Waar het goed in is
De vuistregel: hoe vaster de betekenis van een veld, hoe beter het resultaat. Dit zijn de documenten waar het in onze projecten het meeste oplevert.
- Inkoopfacturen. Leverancier, nummer, datum, regels, btw, totaal. De opmaak is per leverancier anders, maar de betekenis is universeel. Dit is bijna altijd de eerste toepassing, zeker in combinatie met een koppeling met je boekhouding.
- Formulieren. Intakeformulieren, aanvraagformulieren, schadeformulieren. Als jij het formulier hebt ontworpen, weet je welke velden erop staan en kun je de herkenning daarop afstemmen.
- Standaardbrieven en besluiten. Brieven van verzekeraars, uitkeringsinstanties of overheden hebben een vaste opbouw met kenmerk, datum en onderwerp. Prima om automatisch te registreren en in het juiste dossier te leggen.
- Kerngegevens uit contracten. Partijen, ingangsdatum, looptijd, opzegtermijn, bedragen. Niet de juridische betekenis, wel de metadata die je nodig hebt om een contract terug te vinden en op tijd te handelen.
- Medische en arbeidsdeskundige stukken. Classificeren en op de juiste plek in het dossier leggen werkt goed. De inhoud beoordelen blijft mensenwerk, en dat willen de betrokken professionals ook zo.
Waar het slecht in is
Eerlijk is eerlijk: er zijn documenten en taken waar we het afraden, of waar je de verwachtingen moet bijstellen.
| Situatie | Wat er misgaat | Wat je eraan doet |
|---|---|---|
| Handschrift | Herkenning is wisselend, zeker bij cijfers en namen. | Alleen classificeren, invoer door een mens. |
| Slechte scans en foto's | Scheef, donker, deels afgesneden: OCR mist tekens. | Kwaliteitscheck vooraf, terugsturen naar de afzender. |
| Complexe tabellen | Samengevoegde cellen en regels over meerdere pagina's raken door elkaar. | Regelniveau laten controleren, totalen valideren. |
| Interpretatie | "Is deze clausule nadelig voor ons?" is geen extractie maar een oordeel. | Niet automatiseren; hooguit samenvatten als hulpmiddel. |
| Ontbrekende gegevens | Een taalmodel kan een waarde verzinnen die er niet staat. | Verplichte bronverwijzing per veld, anders leeg laten. |
| Rekenen | Optellen en percentages berekenen gaat mis. | Laat het model waarden ophalen en je software rekenen. |
Die voorlaatste regel verdient nadruk. Een taalmodel is gebouwd om een aannemelijk antwoord te geven, ook als het antwoord niet in het document staat. In een goed ingericht systeem moet elk veld daarom verwijzen naar de plek op de pagina waar de waarde vandaan komt. Geen plek, geen waarde. Dat maakt de controle door een mens ook veel sneller: je kijkt naar de gemarkeerde plek en klikt akkoord.
Mens-in-de-lus: zo houd je het betrouwbaar
Wie AI-documentverwerking verkoopt als volledig automatisch, vertelt niet het hele verhaal. In de praktijk bouw je een systeem waarin de software het meeste werk doet en een mens de uitzonderingen beoordeelt. Het verschil met vroeger is dat die mens niet meer alles overtypt, maar alleen nog kijkt waar de software twijfelt.
Zekerheid per veld
Elke herkende waarde krijgt een zekerheidsscore. Boven een drempel die je zelf instelt, gaat het document automatisch door. Daaronder komt het in een controlescherm terecht waar de medewerker het document naast de herkende velden ziet, met de bronplekken gemarkeerd. Corrigeren is één klik, en die correctie wordt vastgelegd.
Harde regels boven zachte herkenning
Validatie is geen AI, het is gewone logica, en juist daarom betrouwbaar. Een factuur waarvan de btw niet klopt met de regels, gaat altijd naar controle, hoe zeker het model ook is. Een leverancier die nog niet in je systeem staat ook. Deze regels stel je samen op met de mensen die het werk nu doen, want zij kennen de uitzonderingen.
Steekproef en leren
Ook van de automatisch verwerkte documenten controleer je er periodiek een aantal. Vind je een fout, dan pas je een regel aan of geef je het model een beter voorbeeld mee. Zo wordt het systeem in de loop van de tijd beter, zonder dat je elke week hoeft bij te sturen.
Privacy, AVG en verwerken binnen de EU
Documenten bevatten persoonsgegevens: namen, adressen, IBAN's, soms medische informatie. Zodra je ze door een AI-model laat lezen, is dat een verwerking onder de AVG en moet je daar bewust over nadenken. We geven geen juridisch advies, maar dit zijn de punten die in elk project terugkomen.
- Waar draait het model. Kies een aanbieder of een eigen omgeving in de EU, en leg vast dat je documenten niet worden gebruikt om modellen te trainen. Bij zakelijke API's van de grote aanbieders is dat meestal contractueel geregeld, maar controleer het.
- Verwerkersovereenkomst. Met elke partij die je documenten ziet, ook de modelaanbieder, sluit je een verwerkersovereenkomst. Je bouwer hoort je daarbij te helpen.
- Dataminimalisatie. Stuur alleen naar het model wat nodig is. Een document hoeft niet bij de aanbieder bewaard te worden; verwerken en verwijderen is de norm.
- Bijzondere persoonsgegevens. Medische gegevens, zoals in letselschade- en arbo-dossiers, vragen extra zorg. Vaak kies je dan voor een model dat binnen je eigen omgeving draait, of voor alleen classificeren zonder de inhoud naar buiten te sturen.
- Bewaartermijnen en logging. Leg vast wat je bewaart van de herkenning en hoe lang. Het logboek is nuttig voor controle, maar ook dat bevat persoonsgegevens.
- Risicobeoordeling. Bij grootschalige verwerking van gevoelige gegevens kan een gegevensbeschermingseffectbeoordeling (DPIA) verplicht zijn. De Autoriteit Persoonsgegevens legt uit wanneer dat zo is. Twijfel je, raadpleeg dan een privacyspecialist.
Wij hosten in eigen beheer in Nederland en de EU en richten documentverwerking zo in dat de klant eigenaar blijft van data en logboeken. Hoe dat er in een echt project uitziet, lees je in de case AI-documentverwerking.
Zo begin je
Documentverwerking is een van de weinige AI-toepassingen waarvan de opbrengst vooraf goed te schatten is: je weet hoeveel documenten er binnenkomen en hoeveel tijd het invoeren nu kost. Zo begin je zonder je te verslikken.
- Kies één documentsoort met volume en een vaste structuur. Inkoopfacturen of je eigen intakeformulier zijn de klassiekers.
- Verzamel een set echte voorbeelden, inclusief de lelijke: scheve scans, foto's, afwijkende leveranciers. Daar test je op.
- Schrijf per veld op wat het is, waar het staat en wat er moet gebeuren als het ontbreekt.
- Bepaal de validatieregels samen met de mensen die het nu doen. Zij weten welke facturen altijd fout gaan.
- Bouw eerst het controlescherm, daarna de automatisering. Zo is de eerste versie meteen bruikbaar, ook als de herkenning nog niet perfect is.
- Meet: hoeveel documenten gaan automatisch door, hoeveel gaan naar controle, hoeveel fouten glippen erdoorheen. Stuur daarop bij.
Wil je weten of jouw documentstroom geschikt is, kijk dan op AI en data of bekijk hoe documentverwerking past in bredere procesautomatisering. Andere processen die zich goed lenen voor automatisering staan in procesautomatisering: concrete voorbeelden.